你的本地配置,数据中心级。
你已经用满了墙上的插座。保留 root 权限,换上大得多的芯片。
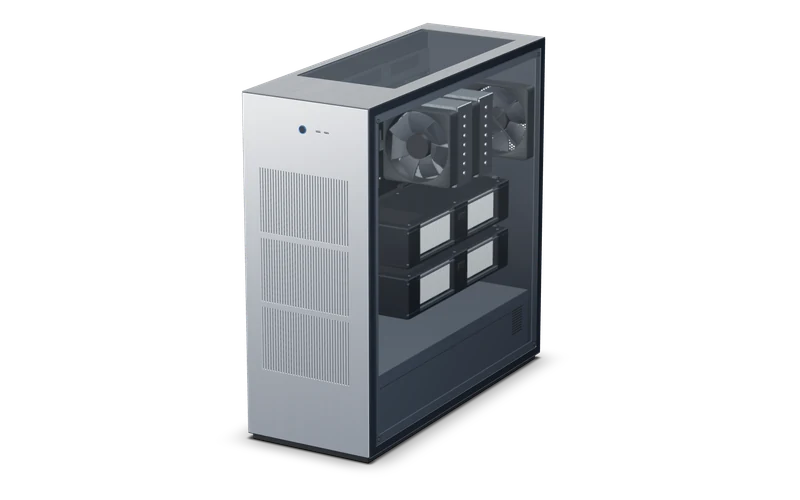
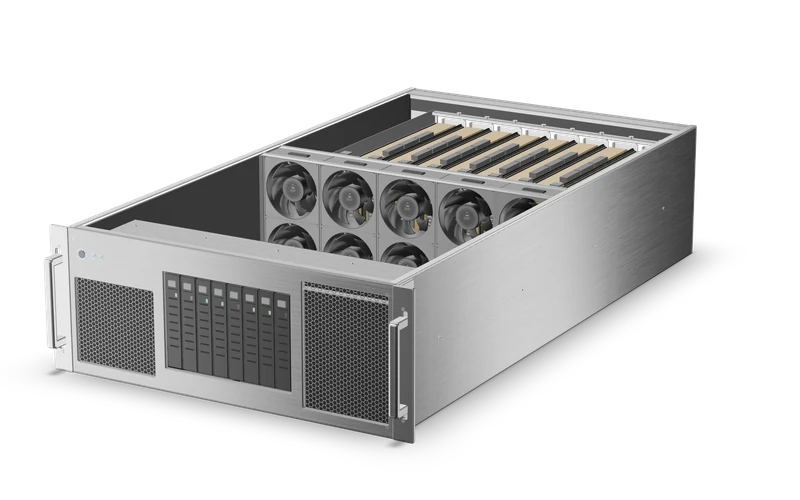
每台机器的最大显存,同一刻度
实心槽位是起步配置,空心的是还能加卡的位置。
- RTX 5090每卡 32 GB GDDR7 · 1.8 TB/s32 GB$7,880 起
- Workstation RTX 5090每卡 32 GB GDDR7 · 1.8 TB/s最多 64 GB$12,506 起
- RTX PRO 6000 Server Edition每卡 96 GB GDDR7 · 1.6 TB/s最多 768 GB$99,971 起
- H200 NVL每卡 141 GB HBM3e · 4.8 TB/s1,128 GB$329,032 起
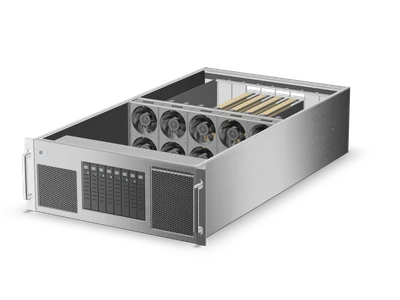
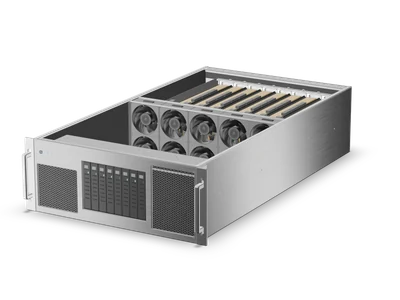
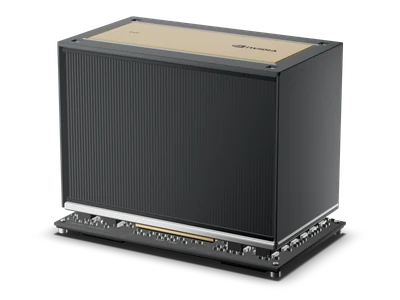
可配置机型:零件按我们的到岸成本计价,外加一笔明示的 5% 组装与 AI 保障费。每个零件都写在配置单上。
保留工作负载,改变运行位置。
你的模型、权重与应用
硬件概念图。目录提供实际内存和扩展范围。多GPU的总显存并非单个可分配空间;运行时、互联、精度与上下文共同决定适配。我们也可将机器运送给你。
部署示意
如何运行
值班电话归我们。
电力、散热、带宽和监控都变成我们的事。机器仍然是你的:裸金属,放在我们机架上期间有保险。
- 冗余供电
- N+1
- 监控与值班响应
- 24/7
- 压力测试
- 48小时
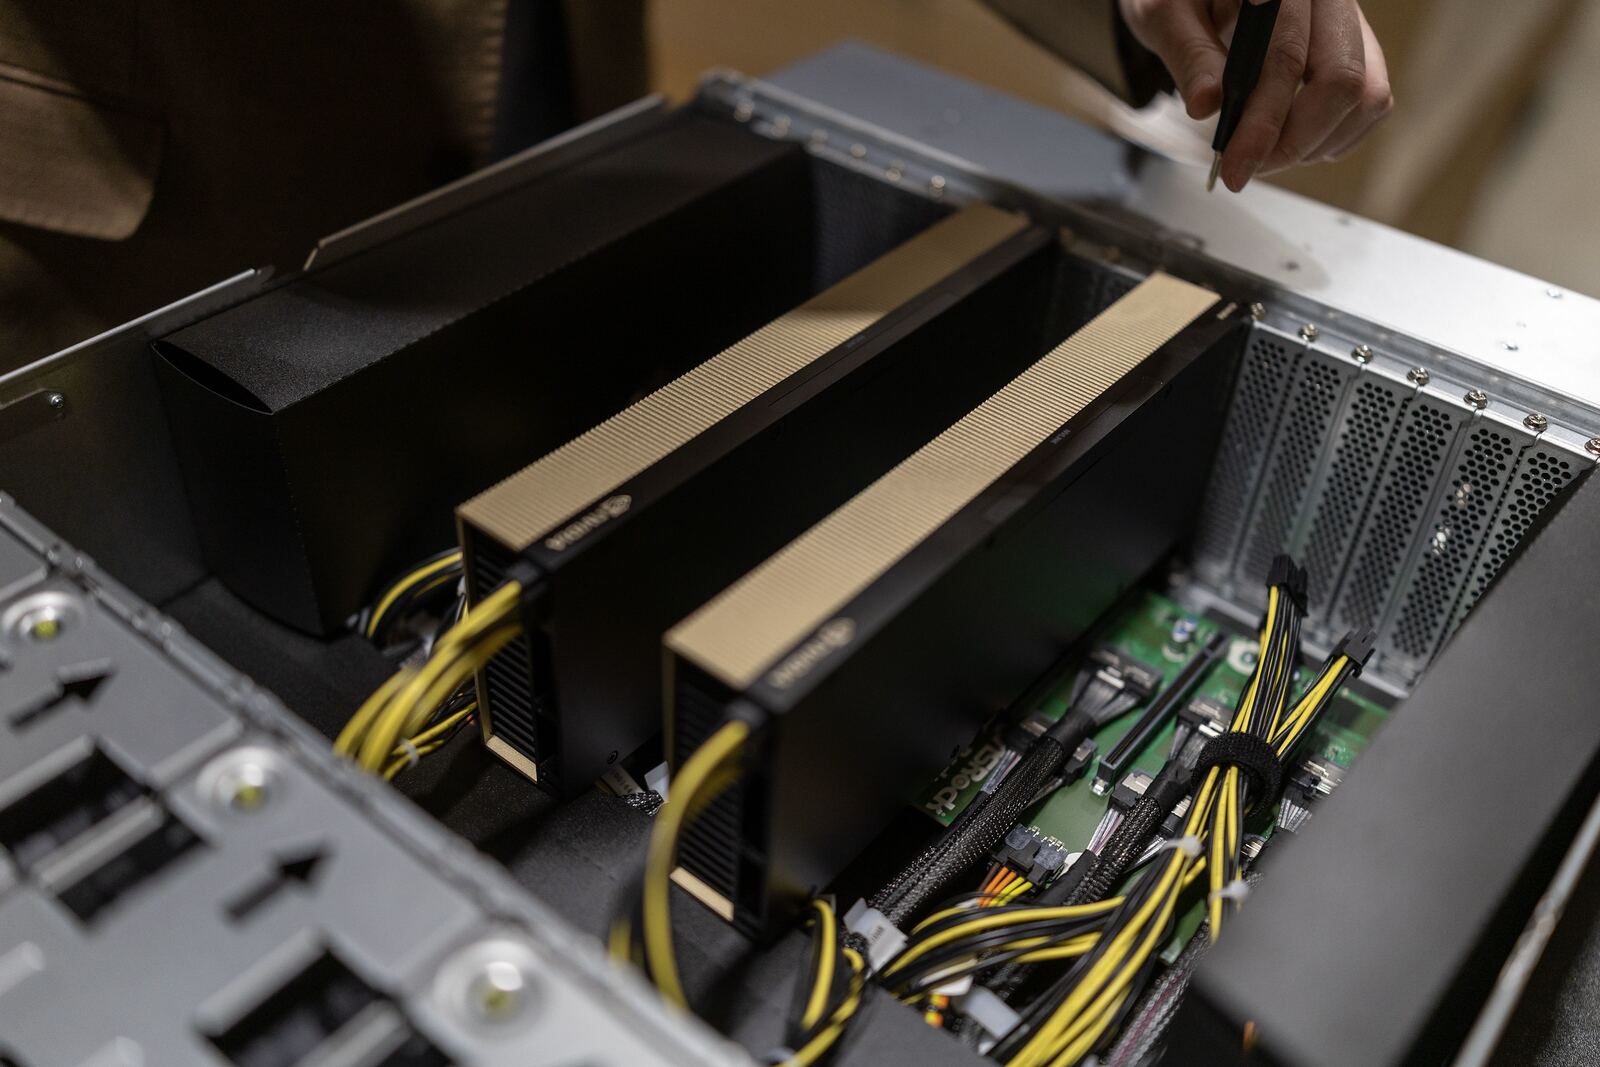
想自己来运行?我们手工组装,然后发货给你。
常见问题
家庭实验室的疑问。
继续堆,我们大多数人都是这么起步的。瓶颈是电力和散热,不是预算:持续的多 GPU 负载需要 240V 电路、冗余散热和真实带宽。我们卖的就是这一部分;硬件仍然是你的。
这是你的机器,裸金属。跑 vLLM、llama.cpp,或者下个月新出的任何东西,需要 OpenAI 兼容端点时,再通过 B3IQ 网关提供服务。
每台托管机器每月都有一项托管服务费,在你决定之前我们会在通话中报出确切金额。你保持私用的机器,按固定金额计费。能赚取收入的机器,这笔费用从收入中扣除;哪个月清淡出现差额,我们只补开差额。我们从收入中抽取的 15% 另计,这也是我们唯一的分成。