对比每一台机器。 速度取决于带宽。
每生成一个 token 都要从 GPU 显存读取一遍模型权重,所以每秒 token 数大致等于显存带宽除以模型在显存中的大小。
显存最快的排在前面。
B3IQ 在售机器,按每块 GPU 的显存带宽排序
机器每块 GPU 带宽起价
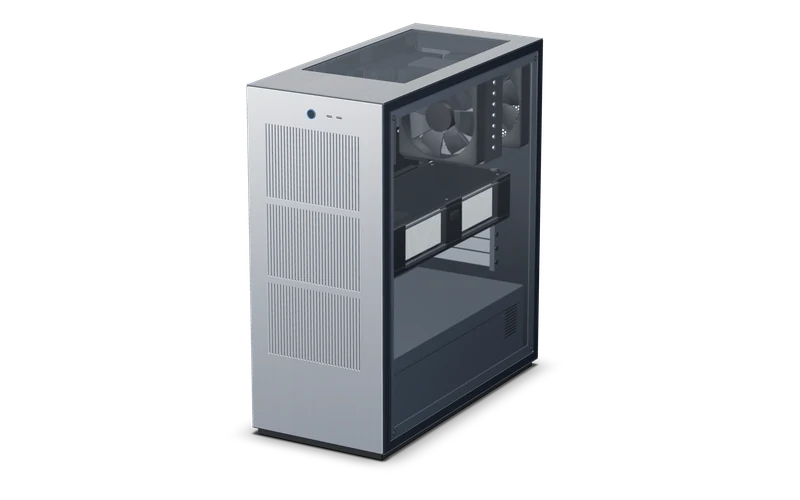
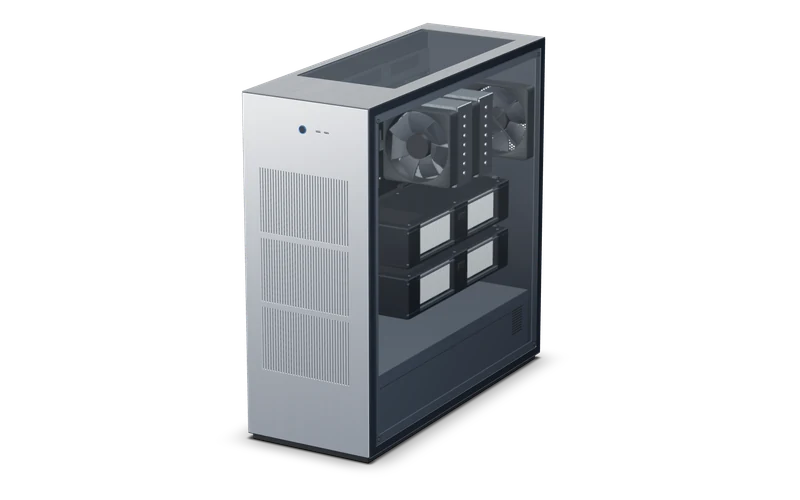
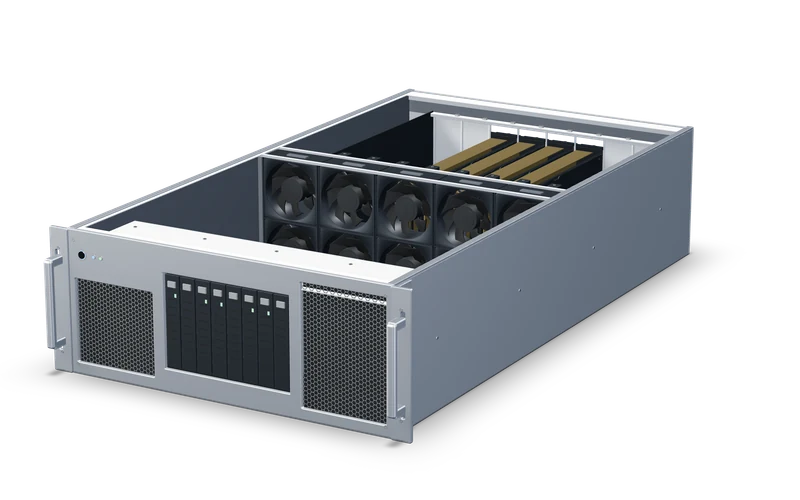
价格 = 我们的零部件到岸成本 + 一笔 5% 的组装与 AI 保障费,零部件不加价。下一步即可配置确切的机型。
了解数字背后的配置。
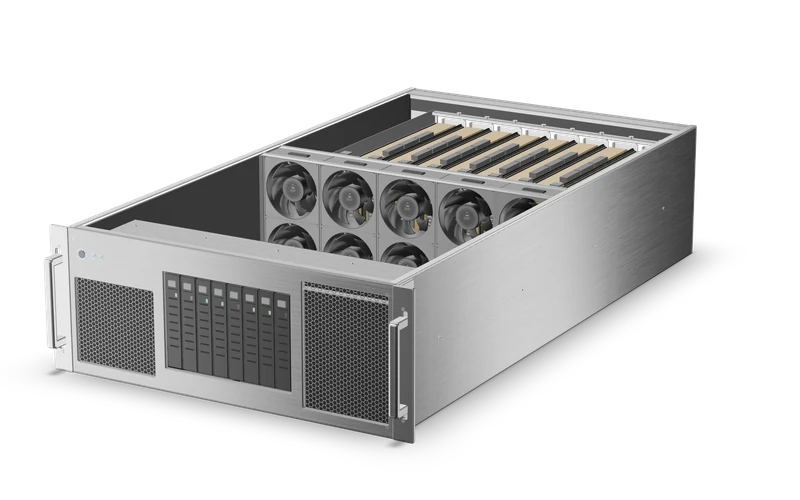
GPU 外观
H200 NVL
- 每个 GPU 的内存
- 141 GB HBM3e
- 每块 GPU 带宽
- 4.8 TB/s
- 已安装 GPU 内存
- 8× · 1.13 TB
- GPU 互连
- 支持 NVLink
已安装的 GPU 内存分布在各张卡上。支持互连并不代表模型能够运行,也不代表单一共享内存池;仍需考虑放置方式、运行时和工作负载。
查看这台机器 ↗外观参考图。各视图独立取景,并非统一的物理比例。模型能否运行取决于运行时、缓存和工作负载。 目录规格说明所提供的配置。下方带日期的社区工作负载参考来自独立运行,并非这台机器的实测性能。
规格表。
显存
H200 NVL$329,032 | RTX PRO 6000 Server Edition$104,171 | RTX 5090$7,880 | Workstation RTX 5090$12,506 | |
|---|---|---|---|---|
| GPU 显存 | ||||
| 系统内存 | DDR5 RDIMM · 1536 GB | DDR5 RDIMM · 512–768 GB | DDR5 UDIMM (consumer) · 64–128 GB | DDR5 RDIMM · 64–512 GB |
整机
| 外形 | 4U 机架 | 4U 机架 | 准专业塔式机箱 | 工作站塔式机箱 |
|---|---|---|---|---|
| NVLink | 有 | 无 | 无 | 无 |
| CPU | 2× AMD EPYC 9355 (32c) | 2× AMD EPYC 9355 (32c) | Ryzen 9 9950X (16c) | Threadripper PRO 9955WX (16c) |
| 存储 | 4 TB NVMe | 4 TB NVMe | 2 TB NVMe | 4 TB NVMe |
| 满载功耗 | 6 kW | 2.8 kW | 1.6 kW | 2.4 kW |
| 交付周期 | 6–8 weeks | 6–8 weeks | ~1 week | ~1 week |
实测速度。
开放模型的每秒 token 数与首个 token 延迟,每种硬件一行。每行最快的一次运行用的是不同的模型,所以请在同一行内比较,而不是跨行比较。
这些是注明来源的社区运行结果,不是 B3IQ 整机的测量。此处未发布 B3IQ 工作负载基准;请在计划使用的配置上验证模型、精度、上下文和并发。
按硬件分列的实测吞吐量
硬件最快一次首个 token模型
H200 SXM878 tok/sQwen3.5-122B-A10B-FP8491 ms5
H200 NVL2665 tok/sQwen3.5-0.8B-Base143 ms5
RTX PRO 6000 Blackwell1048 tok/sGemma-4-26B-A4B-NVFP4—2
RTX 3090303 tok/sLFM2.5-8B-A1B-GGUF144 ms1
Radeon AI Pro R97001405 tok/sQwen2.5-7B271 ms4
RTX 5090286 tok/sNVIDIA-Nemotron-3-Nano-30B-A3B-BF16200 ms1
RTX A5000325 tok/sgemma-3-1b-it-GGUF—2
RX 7900 XTX577 tok/sQwen3.5-9B83 ms2
社区行来自 LocalMaxxing community。 快照日期:2026年5月。 localmaxxing.com
在两台之间犹豫?
下一步:哪些模型放得下